ケーススタディ
Evidence-First RAG
要点
- 対象利用者
- 構造化された定義ファイルを開き、内容を手作業で照合して、メッセージ・シグナル・マッピングの定義に関する質問に答えるエンジニア。
- 課題
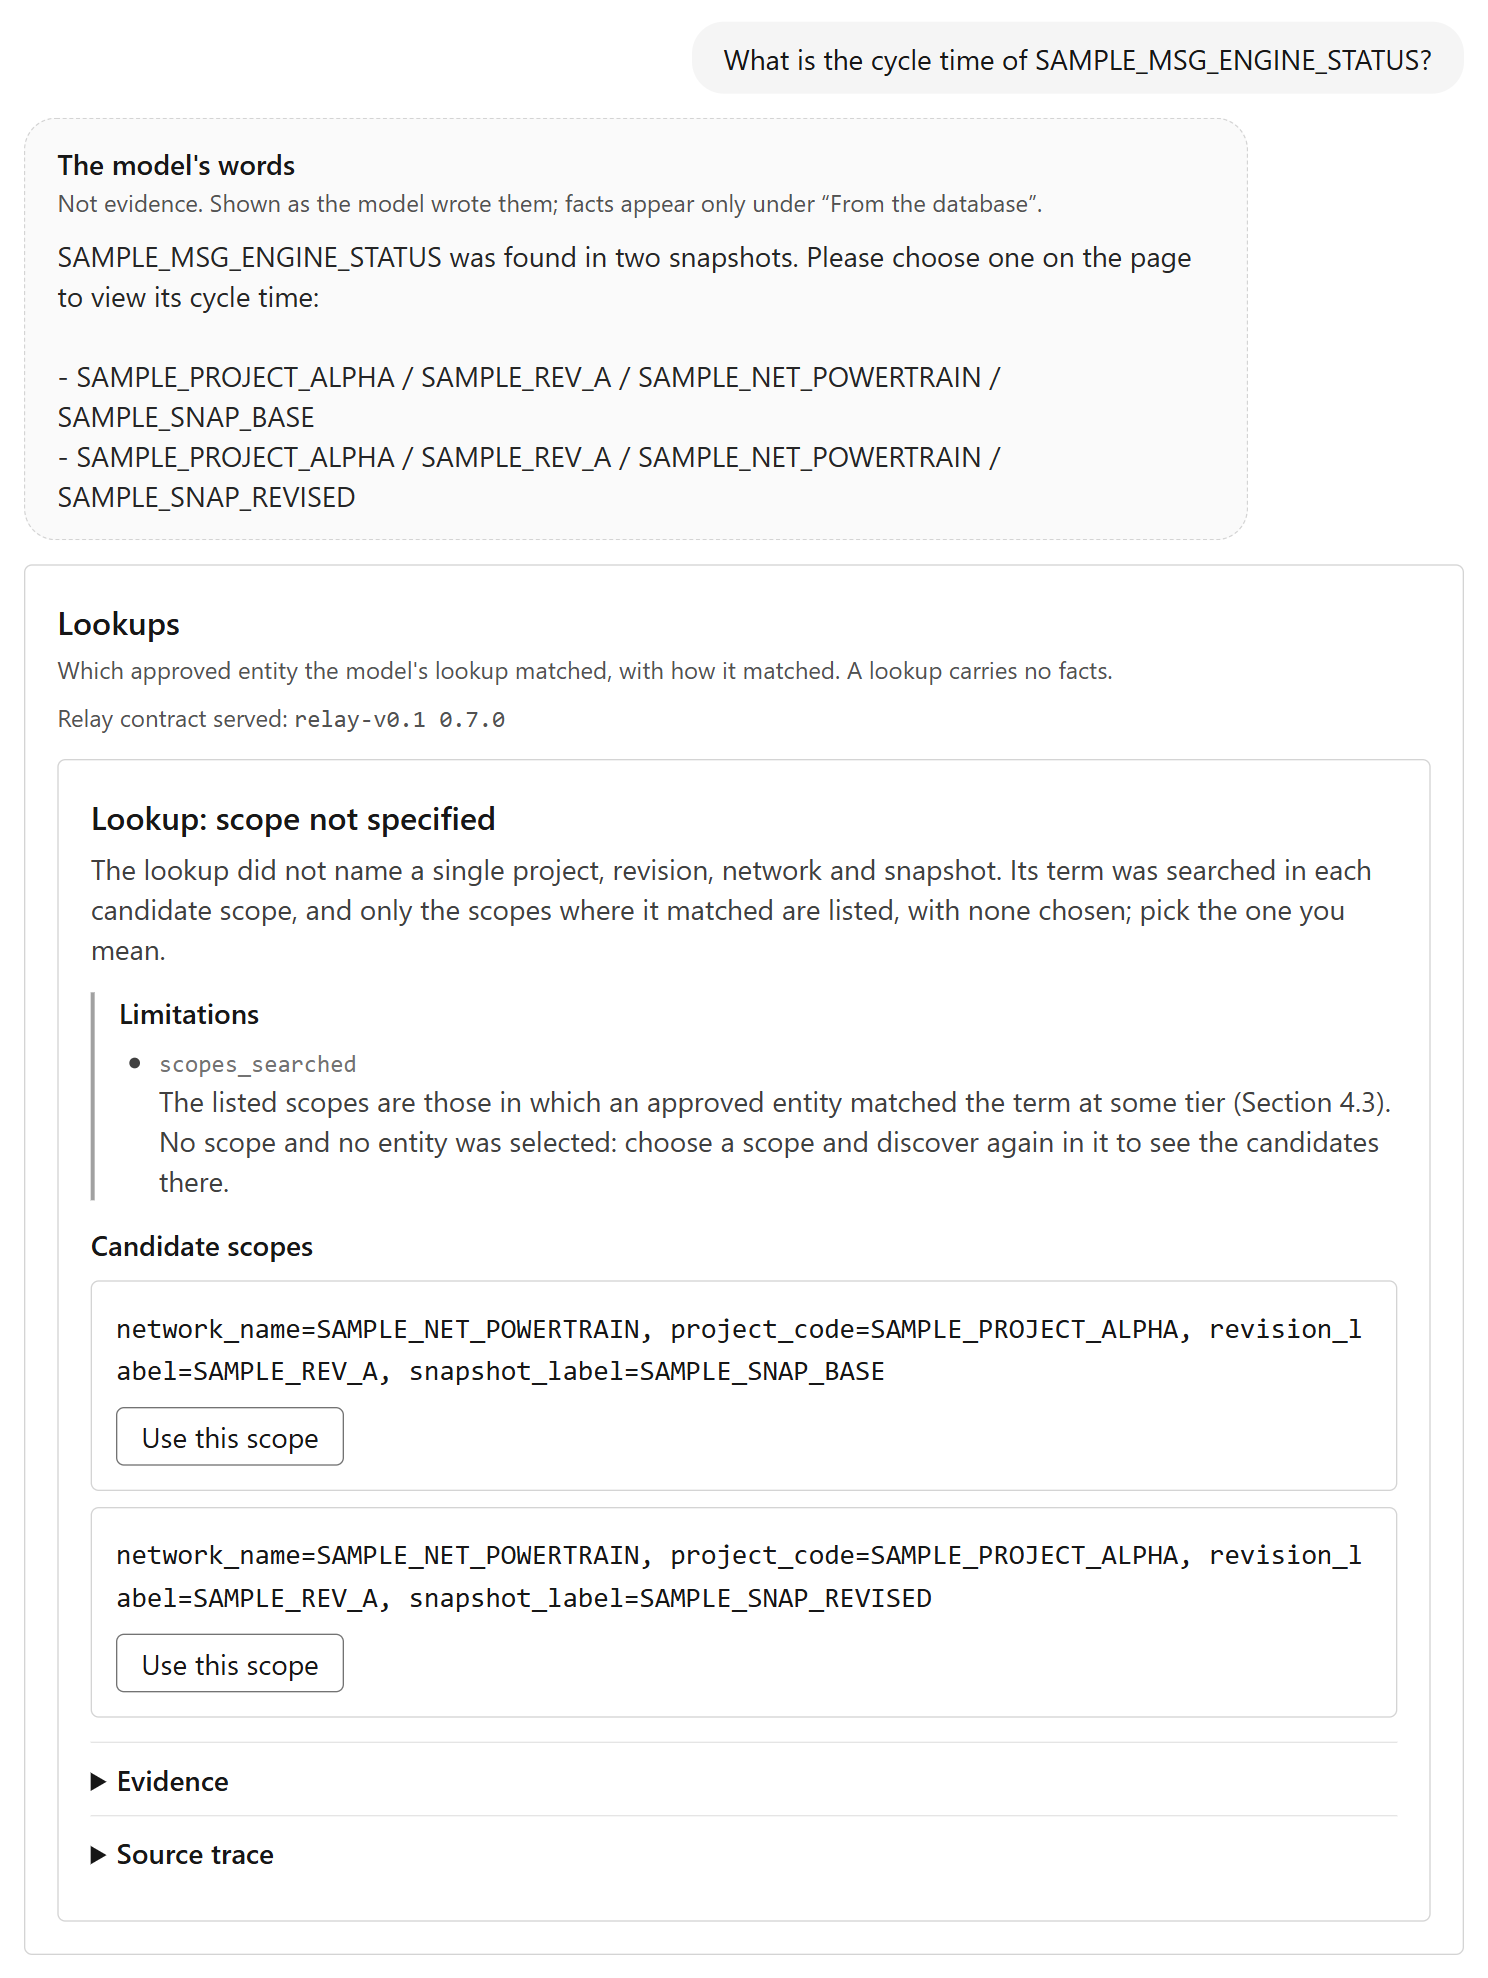
- 同じメッセージ名でも、定義データのバージョンが違えば値が異なることがある。合成データでは、
SAMPLE_MSG_ENGINE_STATUSの周期は、あるバージョンでは 10 ms、別のバージョンでは 20 ms である。名前が一致する検索結果でも、意図していないバージョンの値が返される可能性がある。そのバージョンの値としては正しくても、回答からは取り違えがわからない。ここでいう定義データのバージョンは、定義データの1つのスナップショットを指す。各スナップショットは、1つのプロジェクト・リビジョン・ネットワークに属する。プロジェクト・リビジョン・ネットワーク・スナップショットの4つが、名前とあわせてエントリを特定する条件(スコープ)になる。 - 設計方針
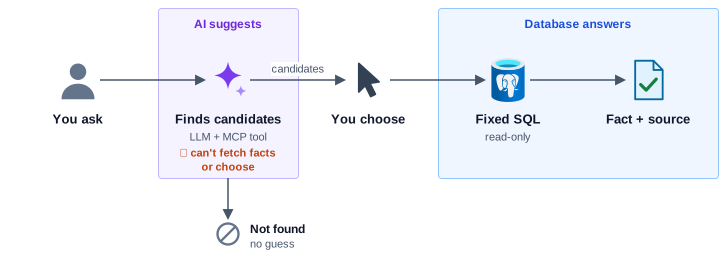
- 言語モデルの役割は、利用者が指す対象(エンティティ)の検索を支援することに限られる。対象の選択は利用者が行う。事実は PostgreSQL に対する登録済み SQL クエリから取得し、画面ではモデルが生成した文章と分けて表示する。
- 実装と検証
- 読み取り専用のクエリランタイム、エンティティ検索、HTTP と MCP のインターフェース、チャットリレーを実装し、Azure にデプロイした。評価は、各実行前に登録した合格基準に照らして判定した。デプロイのたびに、デプロイ先のデータベースをローカルで構築したデータベースと比較している。
- 私が担った判断
- コードと文書の大部分は、AI のコーディングセッション(Claude Code)で作成され、別の AI レビューループで確認された。開発手順上、人が行うと定めた判断は、すべて私が担った。具体的には、各仕様とアーキテクチャ上の判断の承認、合格基準の設定、マイルストーンの受け入れ、マージである。これらの判断は、それぞれリポジトリの Issue とプルリクエストに記録されている。
- 位置づけと限界
- 合成データを用いた個人プロジェクトである。ベクトル検索との比較、テストしていない質問に対する精度、本番運用は示していない。
デモの画面
『From the database』の下
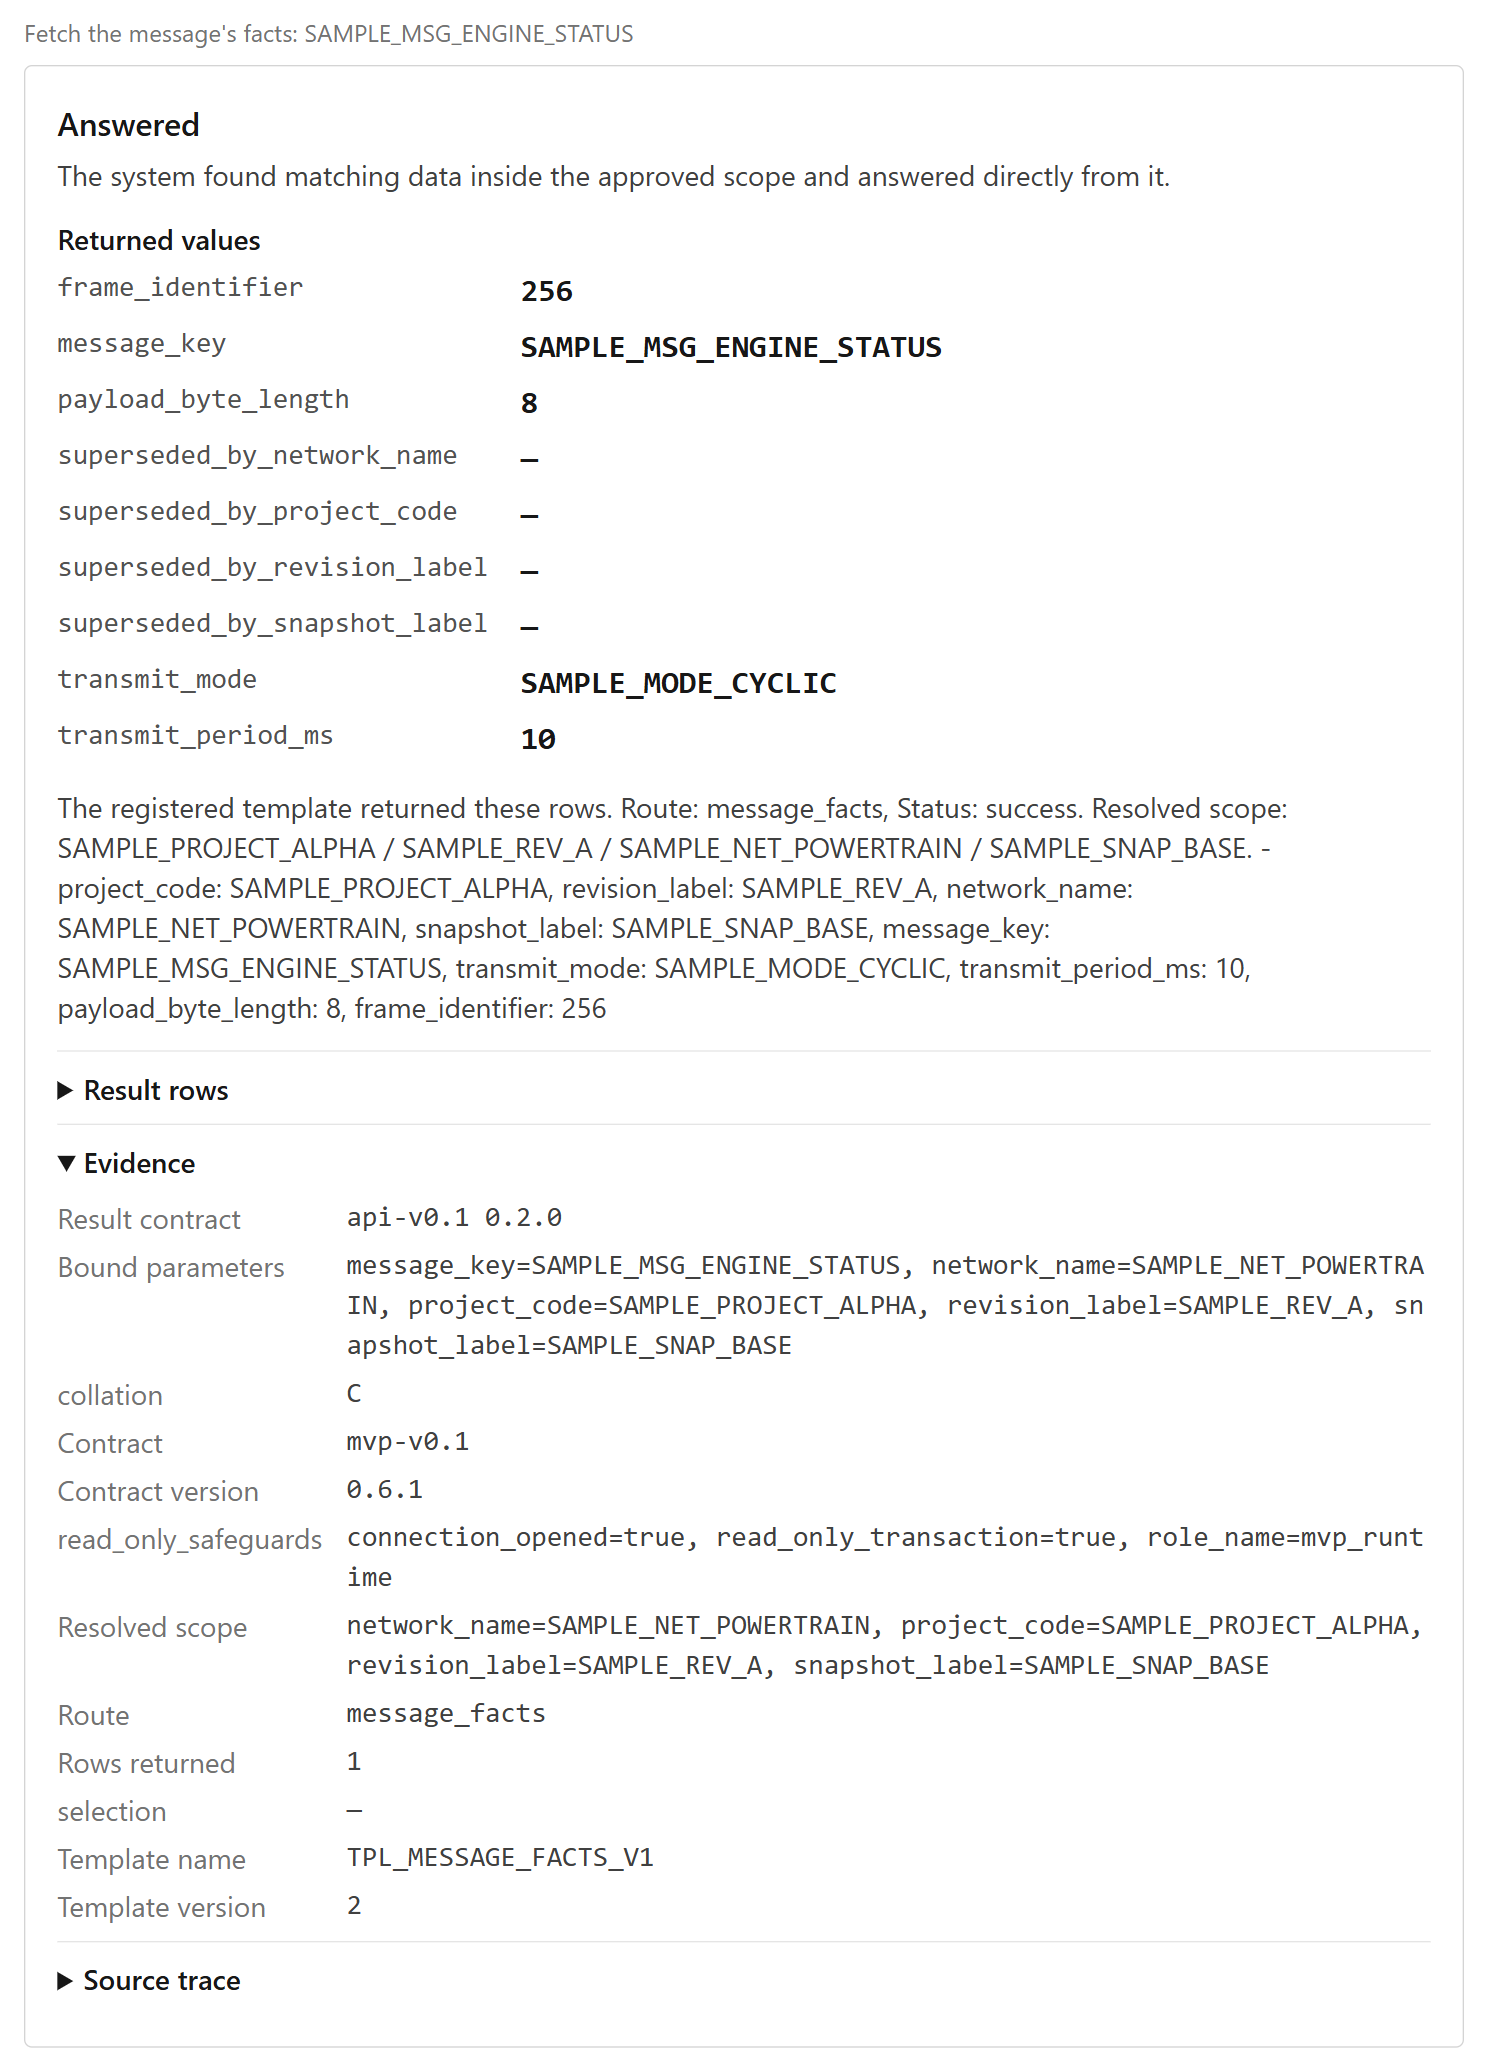
1. 問題
シグナルやメッセージの定義を確認する際、エンジニアは複数の構造化ファイルを開き、手作業で比較することが多い。同じ作業を繰り返すたびに時間がかかり、後から別のエンジニアが結論を確認することも容易ではない。
本プロジェクトは、この作業のための、対応範囲を限定したツールである。メッセージ・シグナル・マッピングについて、スコープを指定した質問に答え、各事実の出典を示す。答えられない場合は、そのことを明示する。
問題意識は、車載ソフトウェアの仕事から生まれた。ただし、データを含むプロジェクトの内容は、すべてこのプロジェクトのために新しく作成した。
2. この設計が避ける失敗
次の3つの失敗を避けるために設計を決めた。各項目では、設計判断、検証方法、トレードオフを説明する。
異なるデータのバージョンにある同名のエントリを混同すること。
合成データでは、SAMPLE_MSG_ENGINE_STATUS の周期は、あるバージョンでは 10 ms、別のバージョンでは 20 ms である。
- 設計判断
- スコープ(プロジェクト、リビジョン、ネットワーク、スナップショット)は、エントリを識別するための情報の一部である。システムは、そのどれについても「最新」や既定の値を決して補完しない。スコープが明確でない場合は回答せず、どれを指すかを聞き返す。
- 検証方法
- 合成データには、同名のエントリを意図的に含めている。登録済みのテストケースと評価ケースで、スコープの指定がない場合や名前が衝突する場合を検証する。
- トレードオフ
- 利用者がデータのバージョンを選ぶ必要のある場面が増え、リクエストに含めるパラメーターも増える。
モデルが生成した文章を事実として扱うこと。
- 設計判断
- モデルが使えるツールは、候補を検索する1つだけである。事実を取得するツールも、対象を選択するツールも持たない。事実は利用者のクリック後にだけ、データベースのルートから取得し、専用の領域に表示する。
- 検証方法
- 使えるツールの構成はリレー仕様で固定している。デプロイのたびにチェックを行い、モデルが検索ツールを呼び出したことを確認する。
- トレードオフ
- クリックが1回増える。モデル自身の文章は検証しておらず、事実以外のことについては誤りを含み得る。他の MCP クライアントには3つのツールがすべて見え、そのために記録したリスクは残る。
Azure とローカル環境で動作が異なること。
- 設計判断
- コンテナイメージとプロビジョニングモジュールをそれぞれ1つに統一し、CI、ローカル環境、デプロイで共用する。デプロイのたびに、デプロイ対象のコミットからデータベースを再構築する。
- 検証方法
- デプロイのたびに、各テーブルの行数、レジストリのダイジェスト、クエリテンプレートのダイジェストをローカルで構築したものと比較し、テストの判定結果も比較する。チェックに失敗した場合は、データベースとイメージの両方をロールバックする。
- トレードオフ
- データベースの状態は保持しない。この運用が成立するのは、データが合成データであるためである。デプロイ中は、数分間デモを利用できない場合がある。
記録: 同名のエントリを含む合成データ · ADR-0002(スコープを含むエントリの識別) · ADR-0005(チャットリレー) · リレー仕様 · デプロイ仕様
3. システムの対応範囲
メッセージ・シグナル・マッピングについて、スコープを指定した質問に答える。回答に使うのは、PostgreSQL に対する、種類を固定した登録済みの読み取り専用クエリだけである。チャットボットではなく、自由形式の SQL も扱わない。
回答できない場合は、次のいずれかの結果で理由を返す。
not_found- : 質問はデータの対象範囲内だが、該当するものがない
coverage_gap- : 質問がデータの対象範囲に含まれていない
ambiguous- : 候補またはスコープが複数ある
unsupported- : 設計上の対応範囲外
invalid_request- : リクエストのスコープや引数が不正、または矛盾している
記録: プロジェクト憲章
4. 設計の変遷
最初の画面はフォームだった。モデルが文からリクエストの下書きを作ることはできたが、検索の前には、エントリの種類(メッセージかシグナルか)とスコープの入力が依然として必要だった。利用者がこのツールを使うのは定義データに何があるかを調べるためだが、フォームは調べる前からそれを知っていることを求めていた。私自身が使ったとき、「temperature」をメッセージとして検索すると not_found が返った。この語はシグナルだが、画面にはそれを示す手段がなかった。
そこで、検索を組み立てる作業を、利用者からモデルに移した。既存の検索と事実取得のルートを MCP ツールにし、利用者が探しているものを自分の言葉で説明すると、モデルがそれを検索に変え、候補はデータベースから返るようにした。これにより、保証が及ぶ範囲も変わった。ツールの結果はモデルに渡り、そのモデルが後から書く文章は、ツールでは制御できない。
MCP ツールを使うには、閲覧者が自分の AI クライアントを持っている必要がある。その AI クライアントでは、モデルがすべてのツールを持つため、利用者の代わりに選んだり、自分で事実を取得したりできてしまう。そこでデモでは、私自身がチャットを運用し、モデルに検索ツールだけを渡すリレーを通すことにした。選択は利用者が行い、事実は利用者のクリック後にだけ表示される。
この間、一貫して変えなかったのは事実の出どころである。事実は、PostgreSQL に対する登録済みの読み取り専用 SQL クエリから取得する。
記録: ADR-0004(MCP のインターフェース) · ADR-0005(チャットリレー) · リレー仕様 · クエリランタイム(受け入れ判定の記録)
5. システム構成
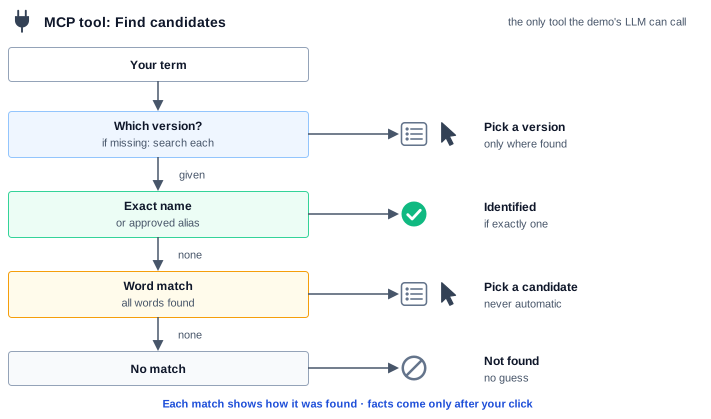
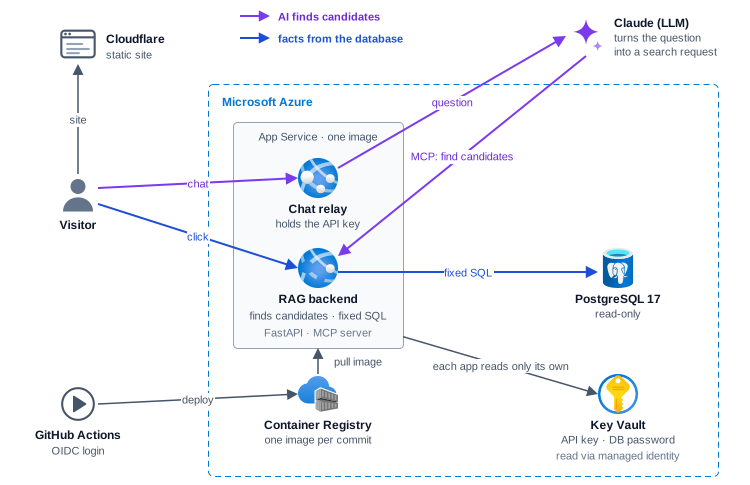
検索の経路と事実取得の経路を分離している。検索の経路は、利用者が入力した言葉から候補を探す。事実取得の経路は、利用者のクリックに応じて事実を取得する。「From the database」と表示された領域に書き込むのは、事実取得の経路だけである。
記録: ADR-0005(チャットリレー) · リレー仕様 · MCP 仕様 · HTTP API 仕様
6. 動作と評価
否定的な結果も含め、すべての結果に根拠情報が付く。内容は、使用したスコープ、クエリテンプレートとそのバージョン、バインドされたパラメーター、行数、出典をたどるための情報(source trace)、制約と限界である。登録済みのテストケースでは、データから別途作成した期待結果と各結果を比較する。
評価は、決定論的なベースラインとのモデルアダプターの比較と、ラベル付きケースによるエンティティ検索の2つであり、いずれも実行前に登録した合格基準に照らして判定した。
評価記録には、限界も明記している。アダプターは評価に使ったものと同じケースで調整され、検索の評価ケースは実装と同じルールに基づいて作成されている。したがって、どちらの評価からも、新しい質問については何も言えない。最初の評価で使ったアダプターは、デモの処理経路では使用していない。
7. デプロイ
- このサイトは、Cloudflare Pages で公開する Astro の静的サイトである。シークレットは保持せず、ブラウザからリレーとデータベースのルートを呼び出す。
- 1つの Azure App Service (Linux) プラン上で、2つのアプリが同じイメージを実行する。
surfaceは HTTP と MCP のインターフェースを提供し、relayはチャットを処理する。 - データベースには Azure Database for PostgreSQL Flexible Server(PostgreSQL 17)を使う。
surfaceは読み取り専用ロールで接続し、relayはデータベースの認証情報を持たない。 - シークレットは Key Vault に格納し、各アプリのマネージド ID で取得する。モデル提供元のキーを取得できるのは
relayだけであり、データベースのパスワードを取得できるのはsurfaceだけである。 - Docker イメージは1つであり、コミットと同じ値のタグを付けて Azure Container Registry に格納する。
- デプロイは GitHub Actions から OIDC を使って行い、クラウド認証用のシークレットは保存しない。手動で開始し、
mainからのみ実行する。チェックに失敗した場合は、データベースとイメージをロールバックする。
記録: デプロイの記録
8. トレードオフ、制約と限界
データと評価
- データはすべて合成データであり、規模も小さい。内訳は、データのバージョン(スナップショット)が4つ、メッセージが7つ、シグナルが13個、マッピングが3件である。この規模で確認した動作から、実際のネットワークのデータベースについては何も言えない。
- ベクトル検索との比較は行っておらず、未知の質問に対する評価もない。
モデルと検索
- モデルが生成した文章は検証していない。モデルが検索ツールを呼び出すかどうかは、このプロジェクトでは制御できない。関連する変更以降、デプロイ先でのチェックでは実行のたびに呼び出しを確認している。ただし、これは確認できた根拠であり、呼び出しを保証するものではない。
- 検索の照合は、意味ではなく単語に基づいて行う。同義語で見つかるのは、承認済みの別名として登録されている場合だけである。それ以外は、検索結果が該当なしとなる。
運用
- デプロイ済みのデモでは、日次の利用制限と、モデルを利用できない状態はまだ観測していない。
- 認証はなく、可用性も保証していない。各アプリは1インスタンス、1リージョンで稼働し、使用するメトリクスはプラットフォーム標準のものに限る。
- 依存関係のバージョンは範囲指定であり、特定のバージョンには固定していない。
記録: 制約と限界
9. 主な設計判断と開発プロセス
このプロジェクトでの2つの判断
同じ名前でも、スコープが異なれば別のエントリとして扱う(ADR-0002)
- 採用した案
- スコープが異なれば、同じ名前でも別のエントリとして扱う。プロジェクト、リビジョン、ネットワーク、スナップショットは、そのエントリを識別するための情報の一部である。システムは不足しているスコープを決して補完せず、どれを指すかを聞き返す。
- 不採用とした案
- 名前だけで回答する案、または最新のデータのバージョンや、1つしか読み込まれていないバージョンで補完する案。
- 理由
違うシグナルについての回答なら、誤りに気づきやすい。危険なのは、意図したスコープとは異なるスコープの正しい事実を返すことである。利用者があるリビジョンを意図しているのに、別のリビジョンの値を返す場合がこれに当たる。どちらも実際の要求であり、古い方に基づくソフトウェアでも、ビルドに成功し、そのソフトウェア自身のテストに合格する可能性がある。そのため、誰も取り違えに気づかない。この問題意識は、技術データを扱う仕事から生まれた。
- 検証方法
- 合成データには、値の異なる同名のエントリを意図的に含めている。スコープの指定がない場合や名前が衝突する場合について、登録済みの評価ケースで、システムが推測せずに聞き返すことを検証する。また、読み込んだデータベースでも同名のエントリが別々に保たれていることを、データのチェックで確認する。
モデルは探すだけで、選ぶのは人(ADR-0005)
- 採用した案
- デモでモデルが使える機能は、候補の検索だけである。候補を選択することも、事実を取得することもできない。選択は利用者が行う。事実として表示するのはデータベースの応答であり、モデルが生成した文章とは別の領域に表示する。
- 不採用とした案
- 質問の文脈からモデルに候補やスコープを選ばせ、事実取得ツールも使えるようにする案。
- 理由
質問にリビジョンの指定がないとき、文脈からそれを推測することがリスクになる。回答が正しい事実でも、利用者が意図したものとは限らない。システムは、曖昧な点を人が確認することを前提とし、曖昧さが残る間は再び聞き返す。
エンジニアがこうしたツールを使う目的は、一般的な回答を得ることではなく、個別の調査を行うことである。一つひとつの事実を信頼できなければ、元の資料を確認し直すことになる。モデルの導入によって、その信頼を損ないたくなかった。
MCP サーバーはどのモデルにも接続できるが、そうしたモデルの動作は検証していない。私自身が運用する経路では、モデルが適切に動作することに頼らず、ツールの構成とリレーのチェックによって、曖昧な場合はシステムが聞き返すようにした。
- 検証方法
- 登録済みのテストで、リレーからモデルへの呼び出しでは検索ツールだけが有効であることを検証する。また、モデルが以前の
ambiguousの結果から取り出したスコープは、利用者が書いたものではないと判定されることも検証する。デプロイのたびに、本番のリレーへ登録済みのメッセージを送り、モデルが検索ツールを呼び出したことを確認する。どちらのチェックも、モデルが生成した文章は読み取らない。
記録: ADR-0002(スコープを含むエントリの識別) · ADR-0005(チャットリレー) · リレー仕様
まだ示していないこと
このプロジェクトでは、モデルの学習、実際の利用者がいるサービスの運用、検索手法の比較、未知の質問に対する結果は示していない。
どう作ったか
コードと文書の大部分は、AI のコーディングセッション(Claude Code)で作成され、別の AI レビューループで確認された。開発手順上、人が行うと定めた判断は、すべて私が担った。具体的には、各仕様とアーキテクチャ上の判断の承認、合格基準の設定、マイルストーンの受け入れ、マージである。これらの判断は、それぞれリポジトリの Issue とプルリクエストに記録されている。